LINEST线性回归函数应用和部分场景对应分析
📘 Excel LINEST 线性回归函数应用和部分场景对应分析
💡 概述: LINEST 是Excel的数组型线性回归函数,支持单自变量、多自变量回归,一次性输出回归全套统计指标,适合业务归因分析(推广费、营收等业务指标相关性分析)。
版本提示:Excel365/WPS新版支持动态数组,输入公式直接回车自动溢出;旧版Excel(2019及更早)需要选中输出区域,输入公式后按 Ctrl+Shift+Enter。
版本提示:Excel365/WPS新版支持动态数组,输入公式直接回车自动溢出;旧版Excel(2019及更早)需要选中输出区域,输入公式后按 Ctrl+Shift+Enter。
📌 基础语法
=LINEST(known_y's, [known_x's], [const], [stats])
- known_y’s(必填):因变量Y,需要预测/解释的指标,例:实付金额
- known_x’s(可选):自变量X,用来解释Y的因子,例:推广费。省略X时,默认X=1,2,3,4…做时间趋势回归
- const(可选):是否保留截距b
- TRUE / 省略:正常回归,保留截距 ✅业务95%场景使用
- FALSE:强制回归线经过原点,b=0;无特殊业务需求不要开启,会扭曲R²
- stats(可选):是否输出全套详细统计结果
- FALSE / 省略:仅输出斜率、截距2个值
- TRUE:输出完整5行×N列矩阵 ✅业务分析必须开启
示例(单变量,推广费预测实付):
=LINEST(实付金额区域,推广费区域,TRUE,TRUE)
📊 LINEST 返回矩阵含义(单自变量,5行2列)
| 行号 | 第1列(斜率相关) | 第2列(截距相关) | 指标含义 |
|---|---|---|---|
| 第1行 | 斜率 k | 截距 b | 回归方程系数 y=kx+b |
| 第2行 | 斜率标准误 | 截距标准误 | 系数估计误差;⚠️不能只看绝对值,评估稳定性优先用T值(系数÷标准误) |
| 第3行 | R² 决定系数 | Y估计标准误 | R²:模型拟合度,等价RSQ函数;Y估计标准误:模型预测Y值的平均误差,单位和Y保持一致 |
| 第4行 | F统计量 | 自由度 df | F检验,判断整套自变量组合的整体线性关系是否来自随机巧合 |
| 第5行 | 回归平方和 SSR | 残差平方和 SSE | SSR:自变量可解释的Y波动;SSE:无法解释的剩余波动;R²=SSR/(SSR+SSE) |
⚡ 单独提取指标公式(搭配INDEX,推荐)
# 提取斜率
=INDEX(LINEST(Y区域,X区域,TRUE,TRUE),1,1)

# 提取截距
=INDEX(LINEST(Y区域,X区域,TRUE,TRUE),1,2)

# 提取R²(等价RSQ)
=INDEX(LINEST(Y区域,X区域,TRUE,TRUE),3,1)

# 提取Y估计标准误
=INDEX(LINEST(Y区域,X区域,TRUE,TRUE),3,2)

# 提取F统计量
=INDEX(LINEST(Y区域,X区域,TRUE,TRUE),4,1)
⚠️ 多自变量场景重点提醒
🔥 核心坑点:LINEST读取X区域是从最右列向最左列读取,输出自变量系数顺序反向!
例:自变量X1推广费(A列)、X2曝光(B列),公式 LINEST(Y, X1:X2,TRUE,TRUE)
输出第一行系数顺序:X2系数,X1系数,截距,极易读错;矩阵变为5行3列。
多变量评估拟合度:优先看调整R²。原生R²存在缺陷:无论新增变量是否有真实业务解释力,原生R²只会变大,具有欺骗性。
✅ 业务分析操作步骤(统计推断优先顺序)
- 整理数据:Y和X一一对应,一条样本一行/一列,清理文本、空值
- 设置参数:const=TRUE,stats=TRUE(业务固定搭配)
- 执行LINEST,生成回归矩阵
- 按优先级解读指标
- ① F检验P:判断模型整体线性关系是否随机
- ② 自变量T/P:判断单个自变量系数是否统计显著
- ③ R²/调整R²:自变量对目标指标波动的解释能力
- ④ 斜率大小:X每增加1单位,Y的平均变动幅度
- ⑤ 标准误:辅助判断系数估算稳定性
- 辅助验证:散点图排查异常值;RSQ函数核对R²结果
🚫 常见报错
| 错误值 | 原因 |
|---|---|
| #N/A | Y、X样本数量不一致;多自变量各行样本不匹配 |
| #DIV/0! | 样本数量不足;自变量X全部是同一个固定值(方差=0,没有波动,无法求解回归) |
| #REF! | INDEX引用矩阵行列位置写错 |
🎯 T值 & P值:判断斜率显著性(核心业务指标)
🔹 T值(T统计量)
含义:T衡量算出的斜率距离「斜率=0」的相对距离,扣除估算噪音。
✅ |T|越大:斜率离0越远,自变量带来的影响越有可能真实存在
✅ |T|越小:斜率靠近0,观测到的效应大概率只是随机波动
类比理解:标准误=估算噪音,T=信号÷噪音
✅ |T|越大:斜率离0越远,自变量带来的影响越有可能真实存在
✅ |T|越小:斜率靠近0,观测到的效应大概率只是随机波动
类比理解:标准误=估算噪音,T=信号÷噪音
计算公式:T = 回归系数 ÷ 该系数对应的标准误
# LINEST自动提取T值完整公式
=INDEX(LINEST(Y区域,X区域,TRUE,TRUE),1,1)/INDEX(LINEST(Y区域,X区域,TRUE,TRUE),2,1)
T值判断逻辑:
- 标准判断:|T|>T临界值 → 系数显著;|T|<T临界值 → 不显著;临界值随自由度df变化
- 经验粗判:|T|>2一般显著;⚠️仅大样本(df>60)可用,小样本必须查表!
🔹 P值(显著性概率,业务优先推荐)
原假设:真实斜率=0(X完全不存在线性影响)
含义:P是在原假设成立前提下,随机抽样,得到当前T值(或更大绝对值T)的概率。
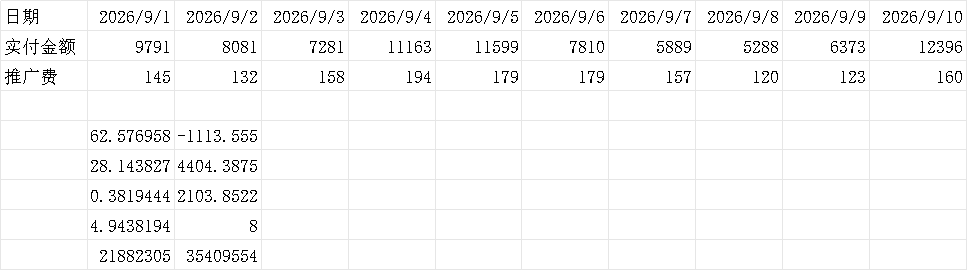
示例P=0.057:即使推广费完全没有线性效果,随机抽10天数据,依然有5.7%概率算出当前正向斜率。
⚠️重要:不能拒绝原假设 ≠ 证明X没有影响;仅说明当前样本证据不足,扩大样本后有可能得到显著结果。
示例P=0.057:即使推广费完全没有线性效果,随机抽10天数据,依然有5.7%概率算出当前正向斜率。
⚠️重要:不能拒绝原假设 ≠ 证明X没有影响;仅说明当前样本证据不足,扩大样本后有可能得到显著结果。
计算公式(双尾检验,回归系数检验固定使用双尾):
=T.DIST.2T( ABS(T值), 自由度df )

# 直接从LINEST计算P值完整公式
=T.DIST.2T(
ABS(
    INDEX(LINEST(Y区域,X区域,TRUE,TRUE),1,1)/INDEX(LINEST(Y区域,X区域,TRUE,TRUE),2,1)
),
INDEX(LINEST(Y区域,X区域,TRUE,TRUE),4,2)
)
📋 P值分级对照表(95%置信 α=0.05)
| 显著性等级 | P值区间 | 结论 | 业务解读 |
|---|---|---|---|
| 高度显著 | P < 0.01 | 拒绝原假设 | 极强证据,X对Y线性影响稳定可靠 |
| 显著 | 0.01 ≤ P < 0.05 | 拒绝原假设 | 有充分证据,X对Y存在稳定线性影响 |
| 边际显著 | 0.05 ≤ P < 0.10 | 不能拒绝原假设 | 观测到微弱趋势,但证据不足,结论谨慎参考 |
| 不显著 | P ≥0.10 | 不能拒绝原假设 | 无充分证据,观测系数大概率来自随机波动 |
一句话口诀:P<0.05 = 显著;P≥0.05 = 不显著(α=0.05为通用约定,可按需调整),单变量、多变量全部通用。
🔗 T值与P值关系 & F检验补充
- 同一组样本:T绝对值越大 → P值越小
- 二者等价,业务优先看P,不需要查表,结论更直观
- 一元线性回归(仅1个自变量):斜率T检验P = 模型F检验P;多自变量回归不满足这个等价关系!
- 例:T=2.223,df=8 → P=0.057;T=2.306,df=8 → P刚好等于0.05;置信区间跨0等价P>0.05,系数不显著
📌 核心总结口诀:
- P值:P小于0.05才算显著,全场景通用
- T值:不能死记2!自由度越小临界T越大;只有大样本,才可以粗略使用|T|>2经验值
- 业务分析优先使用P值,不用查表,结论稳定
📝业务报表示例文案
以推广费为自变量、实付金额为因变量,基于10天数据进行单变量线性回归。
回归方程:实付金额 = 62.58 × 推广费 −1113.56。
R²=0.38,推广费仅能解释38.19%实付金额波动。
斜率T值=2.22,P值=0.057>0.05,系数统计不显著;95%置信区间[-2.32,127.48],区间包含0(跨0等价P>0.05)。
说明:样本量较少,虽然数据呈现正向趋势,但无法确认推广费对实付金额存在稳定线性拉动,不可直接将62.58作为投产系数使用,建议增加数据周期后重新分析。
直接计算斜率函数用:SLOPE 斜率(线性回归)
1. 公式
两点简单斜率:
k = (y₂ − y₁) / (x₂ − x₁)
Excel / PowerBI SLOPE:
最小二乘法,用全部数据拟合一条最优直线,不是只取两点。
=SLOPE(known_y's, known_x's)
– known_y’s:y 值数组(因变量)
– known_x’s:x 值数组(自变量)
2. 斜率代表什么
含义:x 每增加 1 单位,y 平均变化多少单位
- 斜率 > 0:正相关,x上升,y平均上升
- 斜率 < 0:负相关,x上升,y平均下降
- 斜率 = 0:x变化,y基本无线性变化
例子(外卖):曝光x,下单y,slope = 0.02
👉 曝光每+1,下单平均+0.02单;曝光+1000,预估+20单
3. 重要误区
- ✅ 斜率看【变化幅度/方向】,R²看【趋势是否稳定】
- ❌ 斜率大 ≠ 相关性强
- ❌ 斜率只能代表相关,不能证明因果关系
- ❌ 只适合线性趋势;曲线数据会被误导
4. 两点简易斜率计算器
x1: y1:
x2: y2:
结果: